训练和部署大模型,GPU 怎么选?
训练和推理对 GPU 的要求完全不同。本文讲清显存、算力、带宽、互联的区别,给出显存-能力对照、分场景选型、租还是买的判断,以及中国可买型号的注意点。
大模型
 Vincent
输入关键词开始搜索
训练和推理对 GPU 的要求完全不同。本文讲清显存、算力、带宽、互联的区别,给出显存-能力对照、分场景选型、租还是买的判断,以及中国可买型号的注意点。
做聊天/陪伴类 AI 产品,选基座比选模型更重要。本文给出六个选型维度、要避开的“助手腔”陷阱、当前主流开源候选对比,以及一套三天选型对测方法。
SFT 是训练自己模型的第一步,也是最关键的一步。本文讲清 SFT 在训练流程中的位置、数据集格式、只对 assistant 算 loss、全量与 LoRA 的取舍,以及常见踩坑。
训练大模型不只是喂数据。本文讲清预训练、微调、对齐三个阶段,以及从零预训练、继续预训练、LoRA、QLoRA、RLHF、DPO、蒸馏等主流方式,帮你选对路线。
为什么高管、老板、资本家赚得多,不是因为更努力?修仙小说的境界阶梯早就把答案写透了——你的财富上限,约等于你能影响多大范围的规则。
开早会、跟需求、修线上问题、面试……忙了一整天,却说不清为谁而忙。给每件事按「受益对象」归个类,你会看到自己的时间真正流向了哪里。
两个人的旅行,凭什么只有一个人能跟 AI 说话?在 vicvic.im 建个群,两个人 + AI 直接聊,不用再当传话筒。
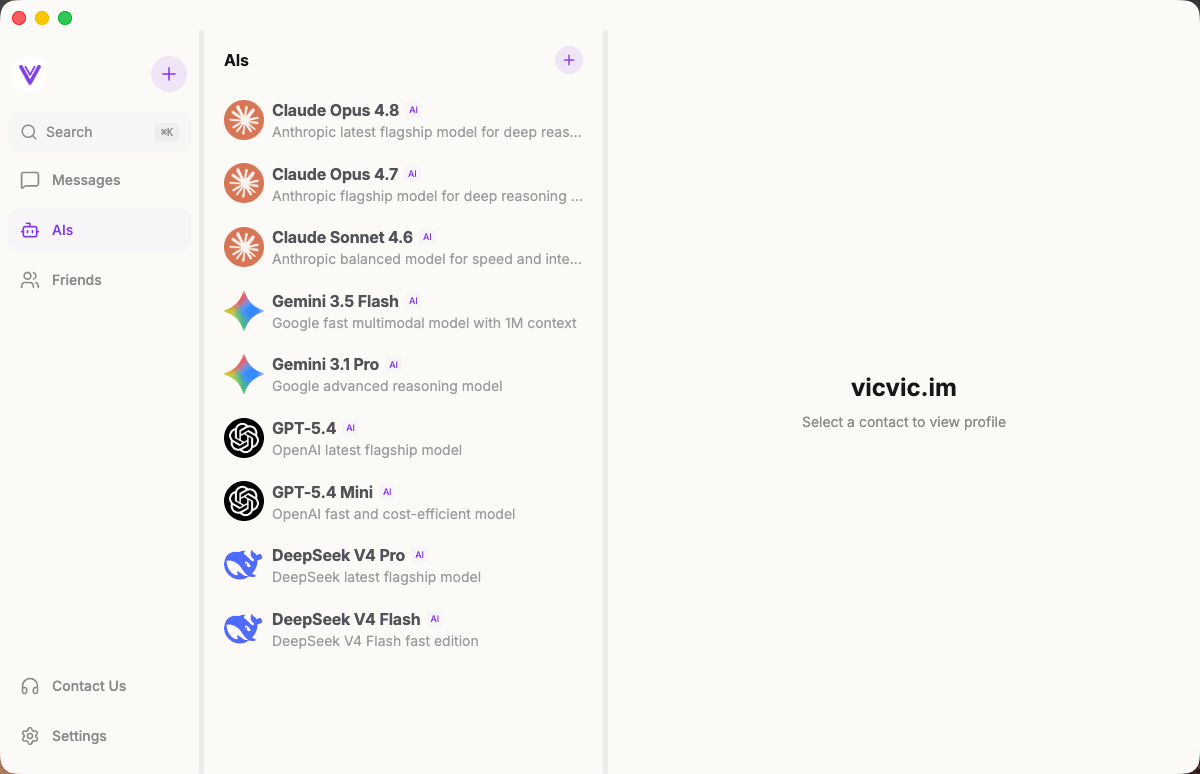
担心单一模型回答不准?在 vicvic.im 里建个群,把 Claude、GPT、DeepSeek 都拉进来,同一个问题让它们各自回答,直接对比。
Claude Code 是怎么一步步理解你的需求、调用工具、自我修复的?从源码角度拆解 Agent Loop 的核心架构——流式响应、并行工具执行、自动压缩、错误恢复,一次讲透。
深入解析 Claude Code 的 hooks 配置——四种钩子类型、核心事件(PreToolUse/PostToolUse/Stop/Notification)、stdin/stdout 协议、exit code 语义,以及实用配置示例。
Claude Code 的 settings.json 到底放哪里?用户级、项目级、本地级有什么区别?什么是 managed-settings.json?一篇讲清 5 层配置的优先级规则、合并逻辑和实际使用场景。
Claude Code settings.json 常用字段速查表:env 环境变量、模型切换、apiKeyHelper 动态认证、Git 署名、思考深度、语言与界面、自动更新等,附可直接复制的配置示例。